从机械零件的三维模型,到网页、短视频,再到大模型的训练语料,李成刚处理的信息对象不断变化。贯穿这些工作的,是一个持续延伸的问题:怎样让计算机从复杂的信息中找到有用的内容,并将其有效利用。
2026 年 8 月,字节跳动 Seed 新设 Pretrain Data 部门,整合此前分散在文本、代码、视觉和语音等方向的预训练数据团队,由李成刚负责,向吴永辉汇报。这项调整,也为观察他从搜索技术走向大模型研究的职业路径提供了新的切入点。
预训练数据的工作,涉及许多用户看不到、却需要反复验证的技术判断:哪些材料适合进入训练,已有语料怎样扩充,不同类型的数据如何组合,以及这些选择最终能否帮助模型获得更好的能力。
在进入这一领域之前,他已经积累了多年的搜索研发经验。按照个人履历,李成刚在清华完成了精密仪器与机械学系的本科和硕士学习,本科阶段另有计算机科学与技术第二学位。毕业后,他进入百度,随后先后担任头条搜索和 TikTok 搜索技术负责人。检索对象从零件模型扩展到网页和视频,系统需要处理的内容形式与用户需求也日益复杂。
进入 Seed 后,他的研究进一步覆盖预训练数据、模型能力预测和数学推理。MGA 关注如何利用已有语料,COD 尝试提前预测大模型的任务表现,Seed-Prover 系列则将证明生成与形式化验证结合,让模型根据反馈修正推理。这些共同署名的研究,为理解他在大模型领域的工作提供了具体线索。
从检索信息,到组织训练材料,再到验证推理结果,李成刚的技术经历逐步展开。要理解这条路径如何形成,还需要回到清华时期,看他怎样从机械设计中的具体问题出发,走进信息检索的世界。
清华求学:机械与计算机的交汇
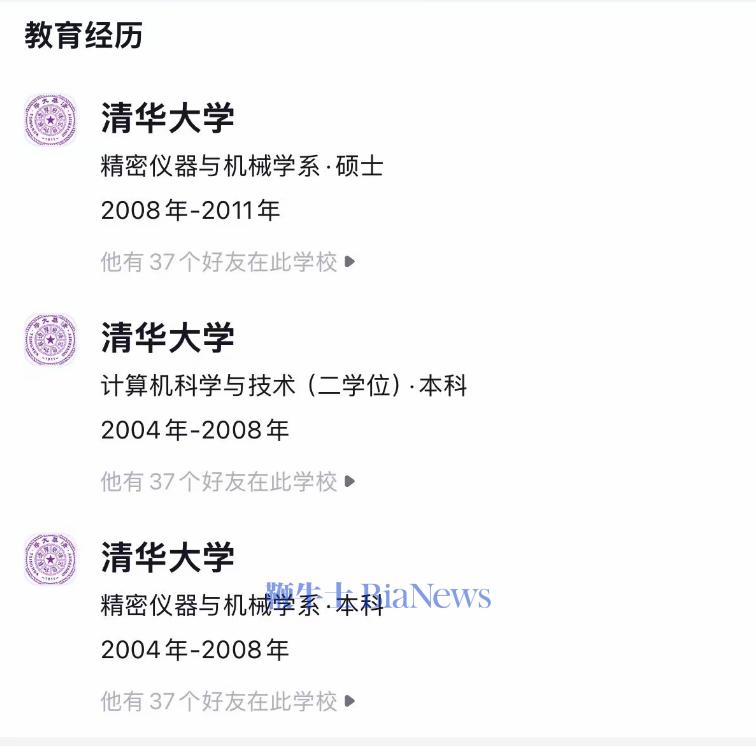
根据其脉脉履历,李成刚于 2004 年进入清华大学精密仪器与机械学系,本科阶段还取得了计算机科学与技术第二学位,随后继续在原院系攻读硕士,于 2011 年毕业。机械设计与计算机技术,在他的学习经历中已有交集。
这种交集也体现在早期成果里。清华大学摩擦学国家重点实验室的记录显示,他参与了“精搜网络机器人系统 V1.0”和“三维模型检索系统 V1.0”。黄利平的教师主页还列有他与黄利平、田凌共同署名的两篇 2011 年论文,分别讨论不确定数据的决策树构建,以及面向特定主题的网页采集系统 THSRS。也就是说,在进入互联网公司之前,他已经开始研究信息的搜集、分类与检索。
三维模型检索尤其能说明他当时面对的问题:一家制造企业已经积累了大量零件设计,工程师开发新产品时,怎样迅速找到形状相近、值得参考的旧模型?
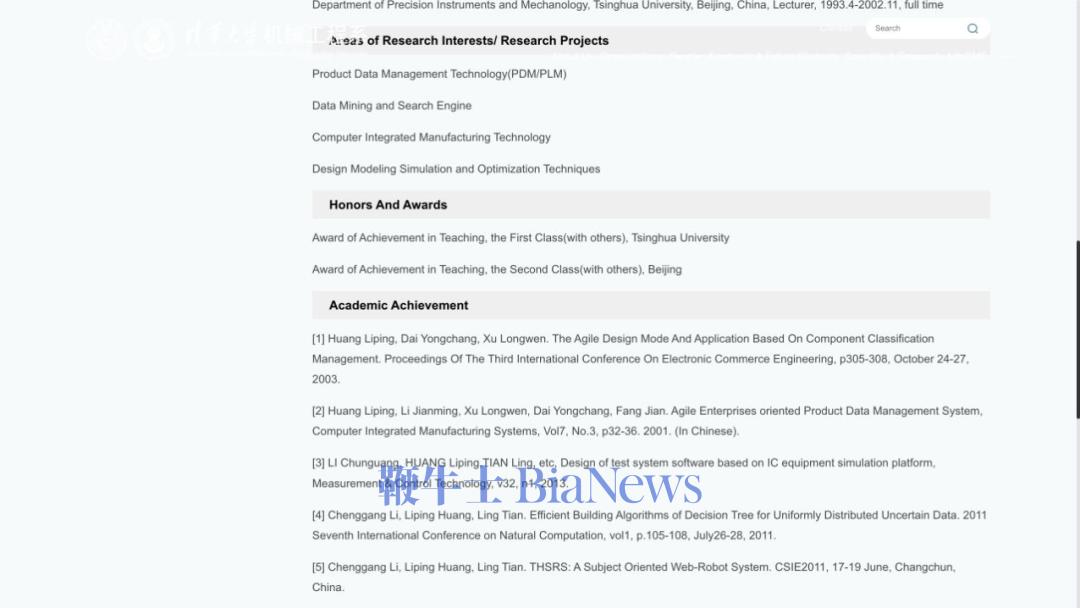
图片来源:黄利平的清华教师主页
从百度到字节:深耕网页与视频搜索
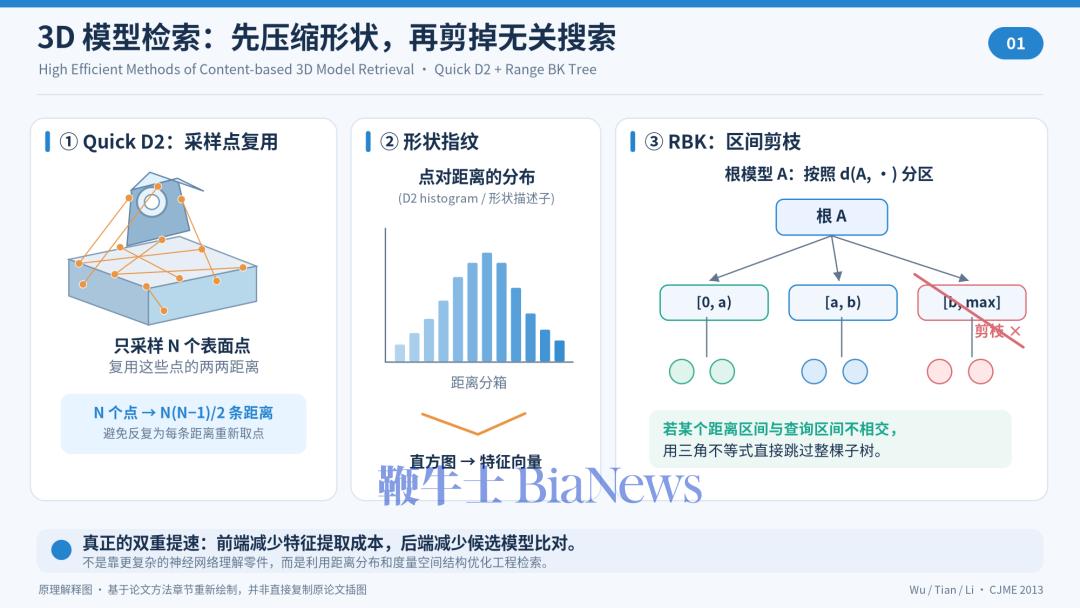
李成刚于2011年7月加入百度,从事技术研发工作,研究方向包括三维模型检索和搜索引擎。 2013 年,李成刚与合作者发表了《High efficient methods of content-based 3D model retrieval》。团队改进了形状特征提取算法,并设计索引来减少检索时需要逐一比较的模型数量,最终实现了“3D Searcher”系统。论文报告,在其测试条件下,单次在线查询的平均响应耗时减少了 75%,并展示了系统用于汽车后桥设计的实例。其直接价值,是缩短设计人员寻找已有模型的时间,让设计复用更容易落实到工作流程中。
此后的互联网搜索工作,李成刚把类似的问题带到了更大的信息规模中。
李成刚于2017年12月8日离开百度,并加入字节跳动。2017 年 12 月至 2021 年 9 月,他担任头条搜索技术负责人;随后转任 TikTok 搜索技术负责人,直至 2023 年 5 月。两段经历分别对应网页搜索和视频搜索,也构成了他进入 Seed 之前最主要的工程履历。 他的具体工作领域还包括排序架构与算法,以及多语言、多模态相关性。
在头条,他参与建设的搜索系统,要承接用户主动提出的问题。2019年8月,北京商报记者体验头条搜索时,结果里已经出现站外内容。新闻、百科、经验分享都可能与同一个搜索词有关,系统还要判断哪条结果更符合眼前的需求。李成刚做过的排序架构与算法工作,就处在这个环节:把找到的内容排出先后,让用户更快看到有用的结果。
到了TikTok,检索对象扩展到视频,系统还需要处理画面与文字之间的联系。比如,用户想找一道菜的做法,关键步骤可能藏在画面中的动作里,标题却没有写出来;用户换一种语言提问,系统也需要理解不同表达所指向的内容。从网页到视频,李成刚的工作逐渐覆盖了不同语言、不同形式的信息怎样与搜索需求对应。
进入 Seed:从预训练研究到AI for Math
2023 年 5 月,李成刚成为 Seed 预训练负责人,开始参与大模型的预训练工作。此前围绕“如何找到信息”积累的经验,也由此延伸到另一个问题:怎样组织训练材料,才能让模型更有效地学习?数据清洗、合成、配比与训练方法,成为他此后工作的重点。
搜索团队与豆包的起步,本就有一段联系。关于字节早期大模型布局的报道提到,2023年初,语言模型方向由搜索部门牵头,其他部门也抽调人员参与。几个月后,对话项目Grace以“豆包”的名字走向公众。搜索中的网页到了训练环节,还要经历另一轮处理:去掉导航、重复片段和无关文字,比较数学、代码、知识与日常表达的配比,并考虑材料的学习顺序。这些数据安排是否有效,要通过训练和评测来检验。
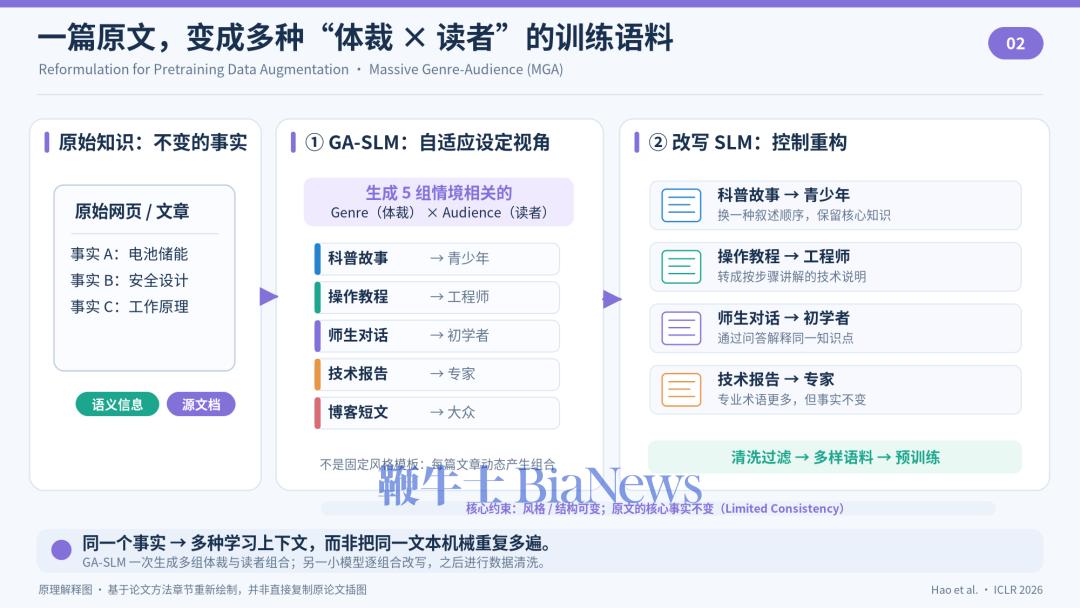
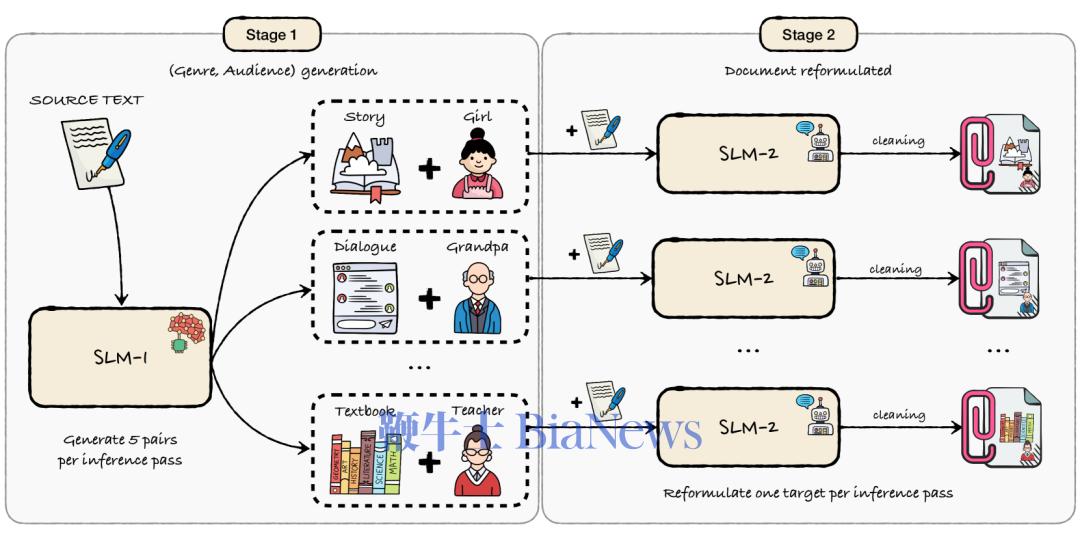
他共同署名的一项数据增强研究,给出了具体例子。这项工作于 2025 年 2 月首次公开,最初以 MAGA 为题,修订后的名称为《Reformulation for Pretraining Data Augmentation》,方法简称 MGA。它针对的是预训练中的现实限制:高质量语料有限,反复使用同一批材料,收益也会受到影响。研究团队尝试围绕不同文体和目标读者,对已有内容进行多样化重述,使同一知识以不同表达形式进入训练。
团队开放的语料里,保留了一篇技术文章及其改写结果:原文介绍计算机如何分层存放数据,解释寄存器、缓存、主存和磁盘在速度、容量和用途上的差别。经过改写,这篇技术说明变成了一个面向10至15岁学生的冒险故事,主角是一个叫莉莉(Lily)的女孩。
故事里,莉莉穿过一道神秘入口,来到电脑内部的世界。她首先遇到一个闪亮的小盒子——它代表CPU里的寄存器,存取信息很快,能装的东西却很少。接着,她找到一个魔法衣柜——里面放着电脑经常用到的东西,这对应的是缓存。再往前,她来到一座装满书籍的图书馆——书籍代表电脑工作时需要的数据和指令,这里就是主存。到了磁盘所在的区域,她又看见一个分成许多格子的储物箱:东西能装得更多,取出来却要花更长时间。原文中不同存储部件的特点,就这样被编进了莉莉一路探索的情节里。
这篇故事随后成为模型可以学习的一份训练材料。同样的知识,从原文里的定义和说明,变成了人物的行动、途经的场景和身边的物件;换一种体裁,还可以写成对话或其他形式。团队想检验的是:面对高质量数据有限的情况,让模型学习同一份知识的不同讲法,能否比反复学习原文更有效?
但改写得多,不一定学得好。研究团队比较了约束较严格、较宽松以及介于两者之间的方案:太贴近原文,表达的变化有限;放得太开,又会偏离原有信息。实验中,严格保留原文的方案仍会在高重复训练时遇到问题,过度放开的方案则出现了明显的性能退化。 团队最终采用的,是在保留信息与增加变化之间取得平衡的做法。
图片来源:MGA论文
团队据此将一部分约 1950 亿 token 的语料扩展为约 7700 亿 token,并公开了数据集。论文在最高 130 亿参数模型的实验中报告,相较于重复使用原始数据或提高部分数据的采样频率,这种方法取得了更好的表现。其意义在于,为有限语料提供了一种经过实验检验的扩充方式;公开数据集也为其他研究者开展比较实验提供了条件。对于更大模型和更长训练周期,论文仍保留了进一步验证的空间。
与数据怎样构造紧密相关的,还有训练效果能否提前判断。如果只能等大模型全部训完再看结果,做判断的时间就晚了。李成刚与沈科等人参与的另一项研究,尝试用较小模型的表现,提前预测更大模型的成绩。 这项工作后来被ICLR 2026接收。
在论文《Unveiling Downstream Performance Scaling of LLMs: A Clustering-Based Perspective》中,李成刚与合作者提出了 COD 框架:先按照难度变化特征对评测任务分组,再利用更容易预测的任务子集,推算完整评测集上的表现。
研究中,团队使用八个较小模型的信息,预测一个700亿参数模型在八项测试基准上的成绩。按照论文报告,预测结果与实际成绩之间的平均绝对误差为1.55个百分点。 在这组实验里,较小模型已经提供了足够的线索,让团队能够估计更大模型的表现,而不必只等最终成绩揭晓。
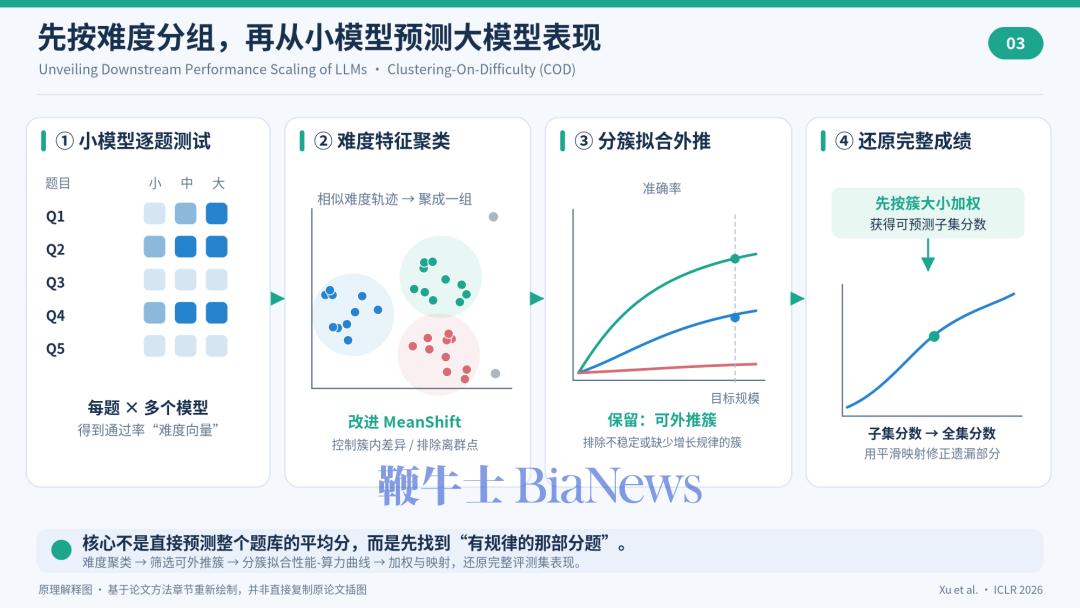
两项研究碰到的都是容易被总量掩盖的问题:语料变多,未必表示学得更好;训练继续,进步也未必沿着原来的速度发生。李成刚与合作者给出的办法,是把问题拆小,再分别检验——改写要比较尺度,预测要区分题目。从这些工作里能看到他的研究取向:关注规模,也关注规模之下的材料和效果。
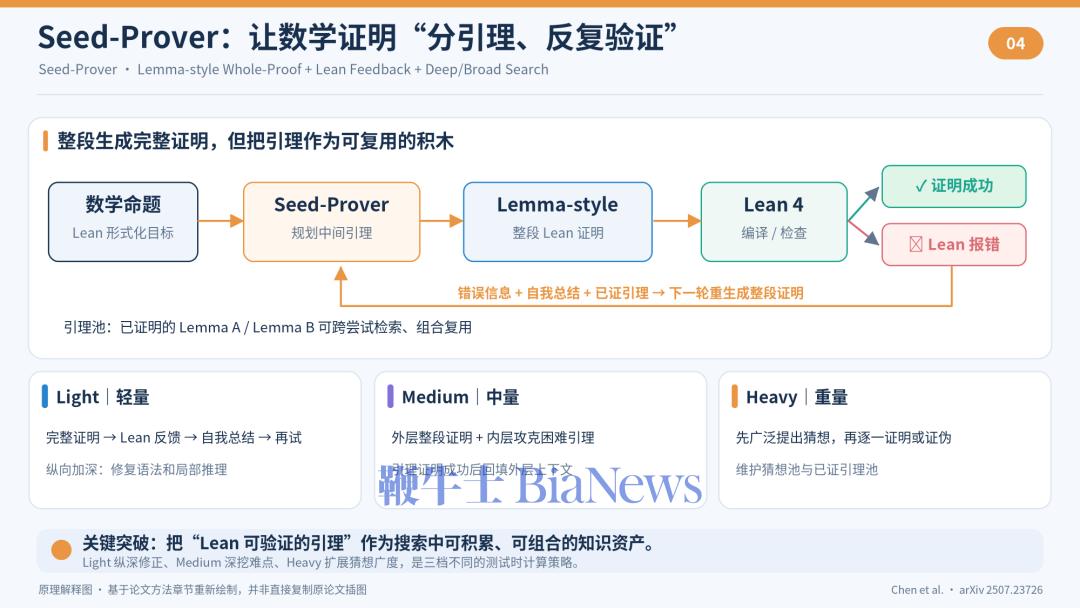
2025 年 5 月起,李成刚转入 AI for Math,目标解决黎曼猜想。2025 年 7 月发布的 Seed-Prover,将数学证明生成与 Lean 形式化验证结合起来。模型生成证明后,可以根据验证反馈修改推理,并利用已经证明的引理继续推进。论文报告,系统在所使用的已形式化历史 IMO 题目集合上证明了 78.1% 的题目。这一结果所对应的是特定评测集合和实验条件,展示了模型在可验证数学推理上的进展。
同年 12 月发布的 Seed-Prover 1.5 进一步引入工具调用:系统可以搜索数学库、运行 Python 辅助计算,并逐步验证和复用中间结论。团队报告,它解决了 PutnamBench 中 88% 的题目,并在 9 小时内为 2025 年 Putnam 竞赛的 12 道题中的 11 道生成了可验证的形式化证明。相关证明代码也已公开,便于外界检查结果。
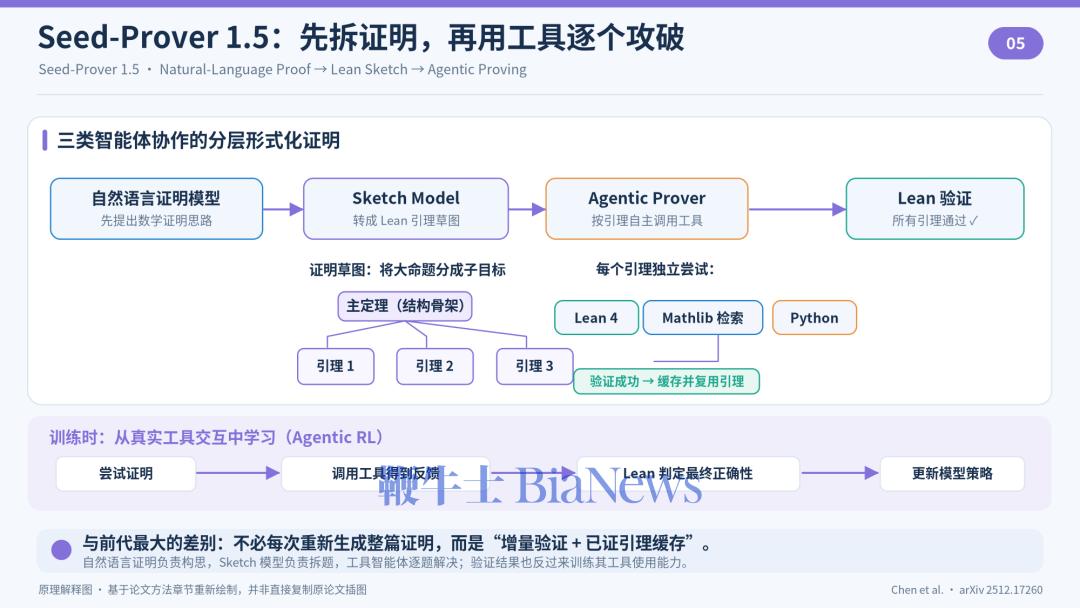
这些研究的重要性,在于让模型的推理过程能够接受明确的正确性检验,并将反馈用于后续学习。
从合作研究,到统筹 Seed 四路数据
2026 年 8 月中旬,Seed 新设 Pretrain Data 一级部门,由李成刚负责并向吴永辉汇报,将分散在各模态的预训练数据收拢为四个分支:
文本分支:由 2018 年清华毕业加入字节、长期主抓超大模型预训练数据的沈科负责;
代码分支:由 Seed-Coder 与 BFS-prover 核心作者 Xia Xiao 负责,与 Horizon RL 负责人唐晟宇共管;
视觉分支:由林毅负责,与世界模型负责人周畅共管(Horizon RL 的视觉强化学习负责人吴侑彬在视觉方向上亦向林毅汇报);
语音分支:统筹音频与语音预训练语料。
这份职责里,有他熟悉的文本,也有做视频搜索时接触过的画面和声音。但训练材料的准备,各有各的难处:文字要处理重复和噪声,图像还可能遇到模糊、歪斜。Seed此前披露的视觉数据制作,就会主动加入模糊和失真。李成刚如今要协调的,是这些准备方法不同、又要共同服务一个模型的专业团队。
2024年,他以语言模型预训练方向负责人的身份出现在导师介绍中;两年后,他需要统筹文本、代码、视觉与语音的数据工作。过去的研究,是和合作者一起把一道具体问题解开;新职责则要求他把几支专业团队的工作组织到一起。 此前两个搜索岗位里的系统研发和多模态经历,也在这里与后来做过的数据研究相接。
从三维零件、网页和视频,到预训练语料与数学证明,他处理的信息对象不断变化。贯穿其中的工作,则是把这些信息组织成系统能够有效使用的形式。在 Pretrain Data 负责人的位置上,这项工作将直接接受模型训练结果的检验。
(转载自Z Finance)
 扫码下载app 最新资讯实时掌握